Elke AI-dienst die over jouw bedrijf praat, heeft je website ergens gelezen. Dat doen ze met crawlers: bots die pagina’s ophalen. Inmiddels zijn het er tientallen, met namen als OAI-SearchBot, Claude-User en Meta-ExternalAgent. Ze doen niet allemaal hetzelfde, en dat is precies waar het vaak misgaat. Wie “de AI-bots” blokkeert, blokkeert vaak ook de bots die ervoor zorgen dat je in ChatGPT, Claude of Perplexity wordt genoemd.
In dit artikel staan alle belangrijke AI-crawlers op een rij, per bedrijf en per functie, met wat je ermee doet.
Eerst dit: er zijn drie soorten AI-crawlers
Bijna elke AI-aanbieder heeft inmiddels aparte bots voor drie taken:
- Zoeken. De bot leest je site zodat de AI je kan vinden en noemen als iemand een vraag stelt. Blokkeer je deze, dan word je niet getoond.
- Op verzoek van een gebruiker. Iemand vraagt de AI om jouw pagina te openen, bijvoorbeeld “wat staat er op de prijzenpagina van dit bedrijf?”. De bot haalt die ene pagina op, op dat moment.
- Training. De bot verzamelt teksten om toekomstige AI-modellen mee te trainen. Blokkeer je deze, dan word je niet meer gebruikt voor training, maar je kunt nog steeds worden gevonden en genoemd.
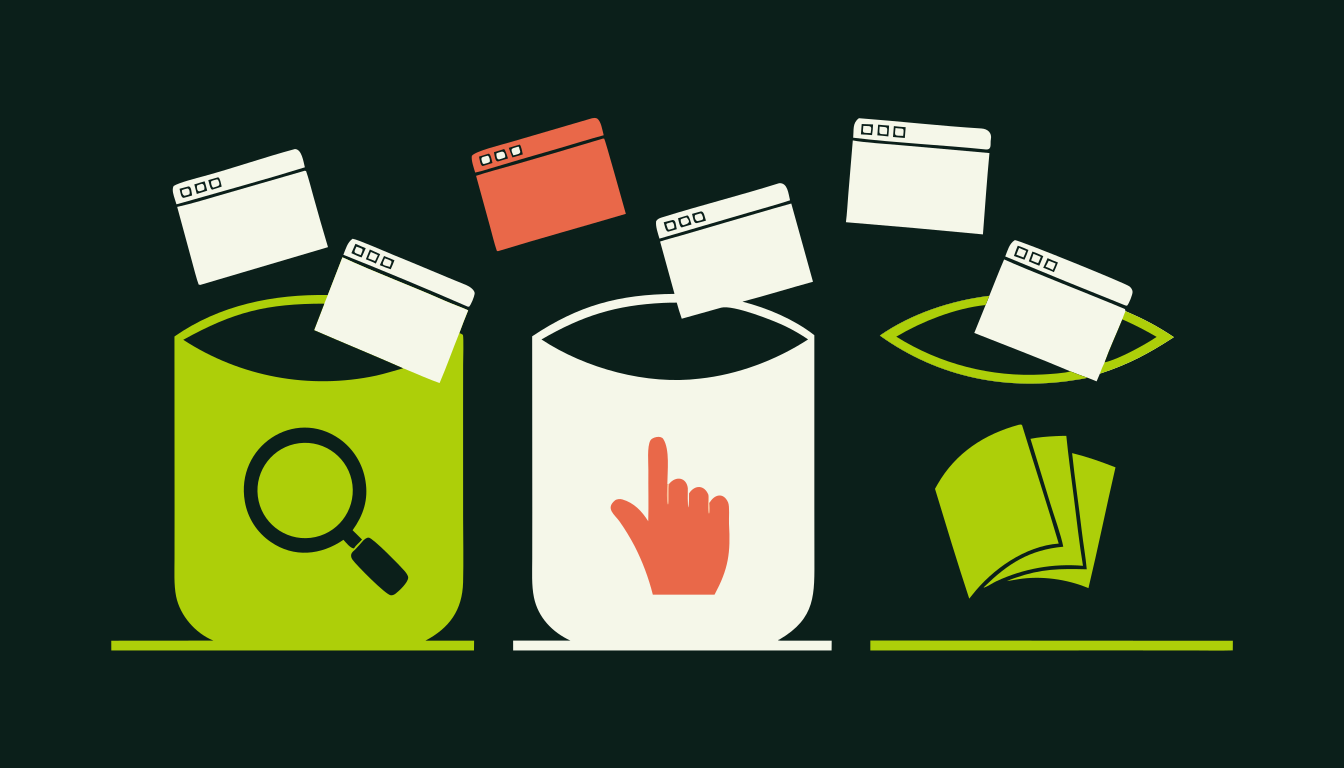
De vuistregel: laat zoekbots altijd toe. Of je trainingsbots toelaat, is een keuze. Daarover verderop meer.
Het overzicht: alle AI-crawlers per bedrijf
| Bedrijf | Zoeken (toelaten) | Op verzoek van gebruiker | Training |
|---|---|---|---|
| OpenAI (ChatGPT) | OAI-SearchBot | ChatGPT-User | GPTBot |
| Anthropic (Claude) | Claude-SearchBot | Claude-User | ClaudeBot |
| Perplexity | PerplexityBot | Perplexity-User | geen (traint niet op je site) |
| Google (Gemini, AI-overzichten) | Googlebot | Google-Agent, Google-GeminiNotebook | Google-Extended (alleen een instelling, geen eigen bot) |
| Microsoft (Copilot) | Bingbot | n.v.t. | n.v.t. |
| Apple (Siri, Apple Intelligence) | Applebot | n.v.t. | Applebot-Extended (alleen een instelling, geen eigen bot) |
| Meta (Meta AI) | Meta-WebIndexer | Meta-ExternalFetcher | Meta-ExternalAgent |
| Amazon (Alexa) | Amzn-SearchBot | Amzn-User | Amazonbot |
| Mistral | MistralAI-Index | MistralAI-User | MistralAI-Training |
| Common Crawl | n.v.t. | n.v.t. | CCBot (open dataset waarop veel AI-modellen zijn getraind) |
Hieronder per bedrijf wat je moet weten.
OpenAI: OAI-SearchBot bepaalt of je in ChatGPT staat
Dit is de belangrijkste en ook de meest verkeerd begrepen. Veel sites blokkeren GPTBot en denken daarmee ChatGPT te blokkeren, of laten GPTBot toe en denken dat ze dan in ChatGPT staan. Allebei klopt niet.
- OAI-SearchBot zorgt dat je site in de zoekresultaten van ChatGPT kan verschijnen. OpenAI zegt het letterlijk: sites die OAI-SearchBot blokkeren, worden niet getoond in de zoekantwoorden van ChatGPT.
- GPTBot is alleen voor training. Blokkeer je GPTBot, dan wordt je content niet gebruikt om modellen te trainen. Je zichtbaarheid in ChatGPT-zoekresultaten verandert er niet door.
- ChatGPT-User haalt een pagina op als een gebruiker daarom vraagt. OpenAI schrijft dat robots.txt-regels hiervoor mogelijk niet gelden, omdat het geen automatische crawler is.
Meer over hoe ChatGPT je site leest, staat in hoe crawlt ChatGPT een website?
Anthropic: drie bots, en ze houden zich alle drie aan robots.txt
Anthropic heeft dezelfde driedeling: Claude-SearchBot voor zoeken, Claude-User voor pagina’s die een gebruiker opvraagt en ClaudeBot voor training. Anders dan bij OpenAI en Perplexity houden alle drie zich aan robots.txt, ook de bot die op verzoek van een gebruiker komt. Blokkeer je Claude-User, dan kan Claude je pagina ook niet openen als iemand erom vraagt.
Alles over de Claude-bots staat in ClaudeBot en de andere Claude-crawlers.
Perplexity: zoeken zonder training
PerplexityBot zorgt dat je in de antwoorden van Perplexity kunt verschijnen, met een link naar je site. Volgens Perplexity wordt hij niet gebruikt om AI-modellen te trainen. Perplexity-User haalt pagina’s op als een gebruiker een vraag stelt, en negeert daarbij volgens Perplexity zelf meestal robots.txt.
Google: voor AI-overzichten heb je geen aparte bot nodig
Bij Google werkt het anders. De AI-overzichten en AI Mode in Google Zoeken gebruiken gewoon Googlebot. Google zegt dat er voor AI-overzichten niets extra’s nodig is: geen speciale bestanden, geen speciale code. Sta je goed in Google, dan kun je ook in de AI-overzichten verschijnen.
- Google-Extended is geen bot maar een instelling in je robots.txt. Daarmee bepaal je of Google je content mag gebruiken voor het trainen van Gemini en voor antwoorden in de Gemini-app. Google zegt er nadrukkelijk bij: het heeft geen invloed op je plek in Google Zoeken en is geen rankingfactor.
- Google-Agent is de bot waarmee AI-agents van Google namens een gebruiker op het web navigeren en acties uitvoeren. Google-GeminiNotebook (voorheen Google-NotebookLM) haalt pagina’s op die iemand als bron heeft toegevoegd. Beide komen op verzoek van een gebruiker en negeren robots.txt doorgaans.
Microsoft, Apple, Meta, Amazon en Mistral
- Microsoft Copilot gebruikt de zoekindex van Bing. Microsoft noemt geen aparte Copilot-crawler; Bingbot toelaten is dus wat telt.
- Apple gebruikt Applebot voor Siri, Spotlight en Safari. Applebot-Extended is, net als bij Google, alleen een instelling: Apple schrijft dat die geen pagina’s ophaalt, maar bepaalt of wat Applebot ophaalt mag worden gebruikt voor het trainen van Apples AI-modellen.
- Meta heeft er vier: Meta-WebIndexer voor de zoekfunctie van Meta AI, Meta-ExternalAgent voor training en het verbeteren van producten, Meta-ExternalFetcher voor links die een gebruiker opvraagt (die mag robots.txt overslaan) en FacebookExternalHit voor de linkvoorbeelden als iemand je pagina deelt.
- Amazon gebruikt Amzn-SearchBot voor zoeken in onder andere Alexa, Amzn-User voor actuele vragen van gebruikers en Amazonbot voor het verbeteren van producten, waaronder het trainen van AI-modellen.
- Mistral heeft MistralAI-Index voor zoeken, MistralAI-User voor gebruikersvragen en MistralAI-Training voor training.
Wat betekent “negeert robots.txt”?
Dat een bot zich niet aan robots.txt houdt, klinkt erger dan het is. Het gaat om bots die één pagina ophalen omdat een mens daarom vraagt, vergelijkbaar met iemand die je site in een browser opent. Ze crawlen niet zelfstandig je hele site.
Het laat wel zien wat robots.txt is: een afspraak, geen slot. Wil je echt iets afschermen, dan moet dat achter een inlog. Andersom geldt het ook: als je site onzichtbaar is voor AI, ligt dat zelden aan robots.txt. Veel vaker blokkeert de hosting of een firewall de bots, zonder dat je het weet. Daarover gaat website onzichtbaar in ChatGPT? Je hosting blokkeert AI-crawlers.
Let op als je Cloudflare gebruikt
Cloudflare heeft op 15 september 2026 nieuwe standaardinstellingen ingevoerd. AI-bots zijn verdeeld in drie groepen: Search, Agent en Training. Op pagina’s waar advertenties op staan, worden Agent- en Trainingbots standaard geblokkeerd; Search blijft toegestaan. Wie vóór die datum niet zelf een keuze had gemaakt, kreeg deze standaard.
Twee dingen om te checken:
- Kijk in je Cloudflare-dashboard wat er voor jouw site is ingesteld. Ook zonder advertenties kan er een AI-blokkade aanstaan: sinds juli 2025 vraagt Cloudflare bij elk nieuw domein of AI-crawlers welkom zijn, en wie toen op blokkeren klikte, is dat misschien vergeten.
- Blokkeer Training niet zomaar. Cloudflare schrijft dat bots met meerdere taken, zoals Googlebot, Applebot en Bingbot, worden behandeld volgens al hun taken. Wie Training blokkeert, blokkeert daarmee ook die bots. En dan verdwijn je niet alleen uit AI, maar ook uit Google en Bing.
Toelaten of blokkeren: wat raden wij aan?
Zoekbots: altijd toelaten. OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot, Bingbot, Applebot en de zoekbots van Meta, Amazon en Mistral. Zonder deze bots kan een AI je niet vinden en niet noemen.
Bots op verzoek van een gebruiker: toelaten. Als iemand een AI vraagt om jouw prijzenpagina te bekijken, wil je dat dat lukt. Dat is een klant die op het punt staat te kiezen.
Trainingbots: een keuze. Voor de meeste MKB-bedrijven raden wij aan ook deze toe te laten. Je wilt dat AI-modellen weten wie je bent, wat je doet en waar je zit. Blokkeren ligt meer voor de hand als je content zelf je product is: uitgevers, cursusmakers, onderzoeksbureaus.
Zo ziet het eruit in robots.txt
Wil je alles toelaten, dan hoef je meestal niets te doen: zonder regels mag elke bot alles lezen. Wil je wel zoeken maar geen training toestaan, dan ziet het er bijvoorbeeld zo uit:
# Zoekbots en bots op verzoek: welkom
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
Allow: /

# Training: niet gebruiken
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: Meta-ExternalAgent
User-agent: MistralAI-Training
User-agent: CCBot
Disallow: /

# Alle andere bots
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Twee valkuilen:
- Een bot volgt alleen het blok met zijn eigen naam. Staat OAI-SearchBot in een eigen blok, dan gelden de regels onder
User-agent: *niet meer voor hem. Zet dus in elk blok wat er voor die bot moet gelden. - Blokkeer Googlebot, Bingbot of Applebot nooit om AI te weren. Daarmee verdwijn je uit gewone zoekmachines. Gebruik daarvoor Google-Extended en Applebot-Extended.
Hoe weet je of de bots echt binnenkomen?
Wat in je robots.txt staat, is wat je wilt. Of het ook gebeurt, hangt af van je hosting, je firewall en je beveiligingsplugins. Controleren kan op drie manieren:
- Test het met de echte bots. De gratis Fyrst Insight scan haalt je site op met de user-agents van OpenAI, Anthropic en Perplexity en laat zien waar de deur dichtzit.
- Kijk in je serverlogs of je hostingpaneel of de bots langskomen en welke statuscode ze krijgen. Een 403 betekent geblokkeerd. Wil je daarna de rest van je site technisch nalopen, gebruik dan de GEO-checklist voor WordPress.
- Check de echtheid. Iedereen kan zich als GPTBot voordoen. OpenAI, Anthropic, Google en Perplexity publiceren de IP-adressen van hun bots. Zo kun je onderscheiden wie echt is.
Veelgestelde vragen
Welke AI-crawlers moet ik toelaten om in ChatGPT te verschijnen?
OAI-SearchBot. Dat is de bot die bepaalt of je site in de zoekresultaten van ChatGPT kan verschijnen. GPTBot is alleen voor training en heeft daar geen invloed op. Laat daarnaast ChatGPT-User toe, zodat ChatGPT je pagina kan openen als een gebruiker erom vraagt.
Word ik onzichtbaar in AI als ik GPTBot of ClaudeBot blokkeer?
Nee. GPTBot en ClaudeBot zijn trainingbots. Blokkeer je ze, dan wordt je content niet gebruikt voor het trainen van nieuwe modellen, maar ChatGPT en Claude kunnen je nog steeds vinden via OAI-SearchBot en Claude-SearchBot.
Heeft Google-Extended invloed op mijn positie in Google?
Nee. Google zegt dat Google-Extended geen invloed heeft op je plek in Google Zoeken en geen rankingfactor is. Het bepaalt alleen of je content wordt gebruikt voor het trainen van Gemini en voor antwoorden in de Gemini-app. De AI-overzichten in Google Zoeken gebruiken gewoon Googlebot.
Houden alle AI-crawlers zich aan robots.txt?
De zoek- en trainingbots van de grote aanbieders wel. Bots die een pagina ophalen op verzoek van een gebruiker, zoals ChatGPT-User, Perplexity-User, Google-Agent en Meta-ExternalFetcher, mogen robots.txt volgens hun eigen documentatie overslaan. De bots van Anthropic houden zich er alle drie aan.
Moet ik trainingbots blokkeren?
Dat is een keuze. Voor de meeste MKB-bedrijven raden wij aan ze toe te laten, omdat je wilt dat AI-modellen je bedrijf kennen. Blokkeren ligt meer voor de hand als je content zelf je verdienmodel is, zoals bij uitgevers en cursusmakers.
Waarom ziet ChatGPT mijn site niet, terwijl mijn robots.txt alles toelaat?
Meestal blokkeert je hosting, firewall of beveiligingsplugin de bots, of heb je bij Cloudflare een AI-blokkade aanstaan. Robots.txt is dan niet het probleem. Test met de echte user-agents of je site bereikbaar is, bijvoorbeeld met de gratis Fyrst Insight scan.